DeepSeekを超えて:中国で相次ぐ2026年のAIモデル発表とAIスタックの再評価
一過性のショックなのか、それとも米国外で持続的に成果を生み出す成長エンジンなのか ― そしてAIスタックのどの分野で利益が生まれるのか?
2026年半ばの約8週間で、中国のAI開発企業5社が最先端モデルに迫る6つのAIモデルを発表しました。その重要性は個々のモデルそのものではなく、発表のペースにあります。2025年1月、DeepSeek-R1が唯一コスト面で衝撃を与えましたが、2026年には複数の企業からAIモデルの発表が相次ぎ、その衝撃は価格面だけでなく能力や規模の面にも及んでおり、これらには以下が含まれます:
- Moonshot: Kimi K3
- Z.ai: GLM-5.2
- DeepSeek: V4-Flash, V4 Pro
- Alibaba: Qwen3.8-Max
- ByteDance: Seedance 2.5
現時点で得られている材料から判断すると、これは単に予期せぬ出来事の繰り返しではなく、構造的な変化のように見えます。中国では現在、コンピューティング(計算)資源が現実的に制約を受ける中、最先端に近いモデルを生み出せる継続的かつ組織的な開発体制が構築されています。
変化の背景を説明する上で、以下の4つの動向が役立つと思われます:
- 単独の出来事がパターン化されている。現在、中国のオープンウェイト・モデルは世界の利用ランキングでトップを占めています1。
- その優位性は単に価格の低さではなく効率性にあり、要求の厳しいタスクでも、最も安価な中国発のモデルでは数セントで済むのに対し、米国の主要システムでは数ドルかかります。
- 経済的価値が失われているのではなく、AIスタック内でその帰属先が移りつつあります。7月末から8月にかけての2つの価格改定― OpenAIによるLunaの約80%の値下げ2、DeepSeekによるV4の50~1,100%の値上げ3 ― によって、AI能力の価格は一定の範囲内で推移しており、上限はオープンウェイト・モデルの競争によって抑えられ、下限は不十分なコンピューティング・インフラが支えています。
- コンピューティング資源がボトルネックである。AI能力の単位コストは低下し続ける一方で、アクセラレータ、メモリ、スペース、電力は依然としてひっ迫しています。
最も明確に恩恵を受けるのは依然としてAIを支えるインフラ提供企業であり、その競争優位性はモデル開発企業よりも持続性が高いとみられます。ハイパースケーラーは総需要の拡大と、オープンモデルのホスティング(自社のクラウド基盤上でAIモデルを提供すること)および利用に応じた課金の両面から利益を得ています。最も大きな課題に直面しているのがモデル開発企業です。主導権の目まぐるしい交代が示唆するように競争優位は崩れやすく、割高なバリュエーションを正当化することが一段と難しくなっているからです。一方、企業ユーザーやソフトウェアを実際に導入・運用する企業は、AIのコスト低下によって創出される経済的便益をより多く取り込むようになるとみられます。
この見解に対抗し得るリスクとしては、以下の4つが挙げられます:
- クローズド型AIラボが最先端モデルの性能面で持続的な優位性を確立すれば、価格決定力を維持できる可能性があること
- コンピューティング資源への制約によって、中国のモデル開発のスケール拡大が抑えられる可能性があること
- オープンモデルは、ホスティング、チューニング、セキュリティのコストを加味すると無料ではないこと
- 最先端AIラボの支出が減速すると、AI関連支出が冷え込む可能性があること
結論:中国は米国との差を縮めているが、引き続き最も恩恵を受けるのはインフラ層である
これは「DeepSeekショックの再来」を超える出来事ではあるものの、中国と米国の最先端モデルが対等な立場にあることを示す証拠はまだありません。両国の差は縮まってはいるが、なくなったわけではありません。最も明確に恩恵を受ける企業は引き続き、コンピューティング能力とインフラを提供する企業と、低コストのAI能力を実際に測定可能な生産性向上へつなげる上で最も有利な立場にある企業です。
これはDeepSeekショックの再来なのか?
DeepSeekが与えた2025年1月のショックは、本質的にはコスト面でのショックでした。それは単一企業によって引き起こされ、人間が正解例を教える学習ではなく、モデル自身による強化学習によってモデルのトレーニング・コストを大幅に低減するものです。まだ最先端モデルには及ばないにせよ、有能なモデルが米国以外の地域で生み出される可能性を示しました。市場はこれを「ジェボンズのパラドックス」の観点から解釈しました。マイクロソフトのSatya Nadella CEOは、AIの低コスト化が利用の急増につながると主張し、中国株は急騰しました。
「ジェボンズのパラドックス」とは何か?
資源利用の効率性が上がると、当該資源の総消費量の増加につながる現象を指します。
2026年のAIブームはこれとは異なります。約2カ月間で5社が、それぞれ独自のアーキテクチャやモダリティ(データの種類・形式)により、6つの最先端に近いAIモデルを発表しました(DeepSeekは2度発表)。具体的には、能力面でリードするオープンウェイト・モデルの「Kimi K3」、Alibabaによる企業特化型の「Qwen3.8-Max」、DeepSeekの超低コストモデルの「V4-Flash」、および数週間後に発表された最先端の効率性を誇る「V4 Pro」、一時オープンモデルのトップの座についた「GLM-5.2」、ByteDanceが発表した動画分野でリードする「Seedance」が挙げられます(図表1)。
図表1:中国の主要AIモデルの発表(2026年6~8月)
| 日付 | モデル(開発企業) | 重要なポイント |
|---|---|---|
| 2026年6月16日 | GLM-5.2 (Z.ai) | 一連の発表の先陣を切り、一時オープンソース・モデルのトップの座に就く |
| 2026年7月16日 | Kimi K3 (Moonshot) | オープンウェイト・モデルでトップの性能を確保。GPUの品切れに伴い、登録受付を一時停止 |
| 2026年7月31日 | V4-Flash (DeepSeek) | 価格面で画期的な進展 ― ベンチマーク1回あたりの実行コストは約0.03米ドル、リリース時にオープンウェイト対応 |
| 2026年8月3日 | Qwen3.8-Max (Alibaba) | 2.4兆パラメータのMoEモデル、100万トークンのコンテキストに対応、企業向け用途や長時間・長工程の複雑なタスクを想定 |
| 2026年8月初旬 | Seedance 2.5 (ByteDance) | 他社を大幅に下回る価格でAI動画の主導権を握る |
| 2026年8月13日 | V4 Pro (DeepSeek) | 効率性で最先端を行くフラッグシップモデル ― GLM-5.2と同等の水準でありながら、価格は大幅に低い |
出所:ステート・ストリート・インベストメント・ストラテジー・アンド・リサーチ、会社発表、Artificial Analysis。2026年8月13日時点。中国における2026年のモデルブーム ― 5社が6つのモデルを発表(V4ファミリーは2026年4月にプレビュー済み)。
最も重要なことは、中国が画期的な技術革新で他社に驚きを与えたかどうかではなく、強力なモデルを繰り返し生み出せるシステムを作り上げたかどうか、という点です。当初は懐疑的に見る向きがあったものの、現実を目の当たりにして認めざるを得ない状況が強まっています。
図表2:DeepSeekから中国のAIブームへ
| 比較項目 | DeepSeek, 2025年1月 | 中国のAIモデル発表の波:2026年6~8月 |
|---|---|---|
| 主体 | 単一の企業による出来事 | 5社、6件のリリ-ス(約8週間) |
| 特性 | 画期的なコスト低下 | 単なる価格でなく性能と規模で画期的な進展 |
| 解釈 | 一度限りの例外的事象 | 再現性のある生産システム |
| 最先端モデルとの差 | 明らかに米国に後れをとっている | 競争力を持つ分野もあるが、全体的には米国が依然リード |
出所:ステート・ストリート・インベストメント・ストラテジー・アンド・リサーチ、Artificial Analysis。2026年8月13日時点。
これらの証拠から、企業やアーキテクチャの幅広さ、開発サイクルの短縮、本番環境での大規模導入を特徴とする、より成熟したシステムへと移行していることが示唆されます。ただし、「最先端に近い」状態は「最先端」ではありません。最も優れた能力を備えたシステムが依然として主導権を握っています。格差は解消されたわけではなく縮まったにすぎませんが、今やこのシステムは長期にわたり持続可能とみられます。
AIバリューチェーンの概要
AIの経済的利益を実際に手にしているのは誰でしょうか?NVIDIAの社長兼CEOのJensen Huang氏が提唱した「AIケーキ」という例えを用いると、エコシステムは一連の層として捉えることができます(図表3)。重要なポイントは利益がどこで生み出されるのか、そして競争圧力が最も激しいのはどの分野かという点です。
図表3:AIの価値スタック ― Jensen Huang氏が提唱する「AIケーキ」
コンピューティング資源は希少で代替が困難な基盤。モデル層は競争が最も激しい分野
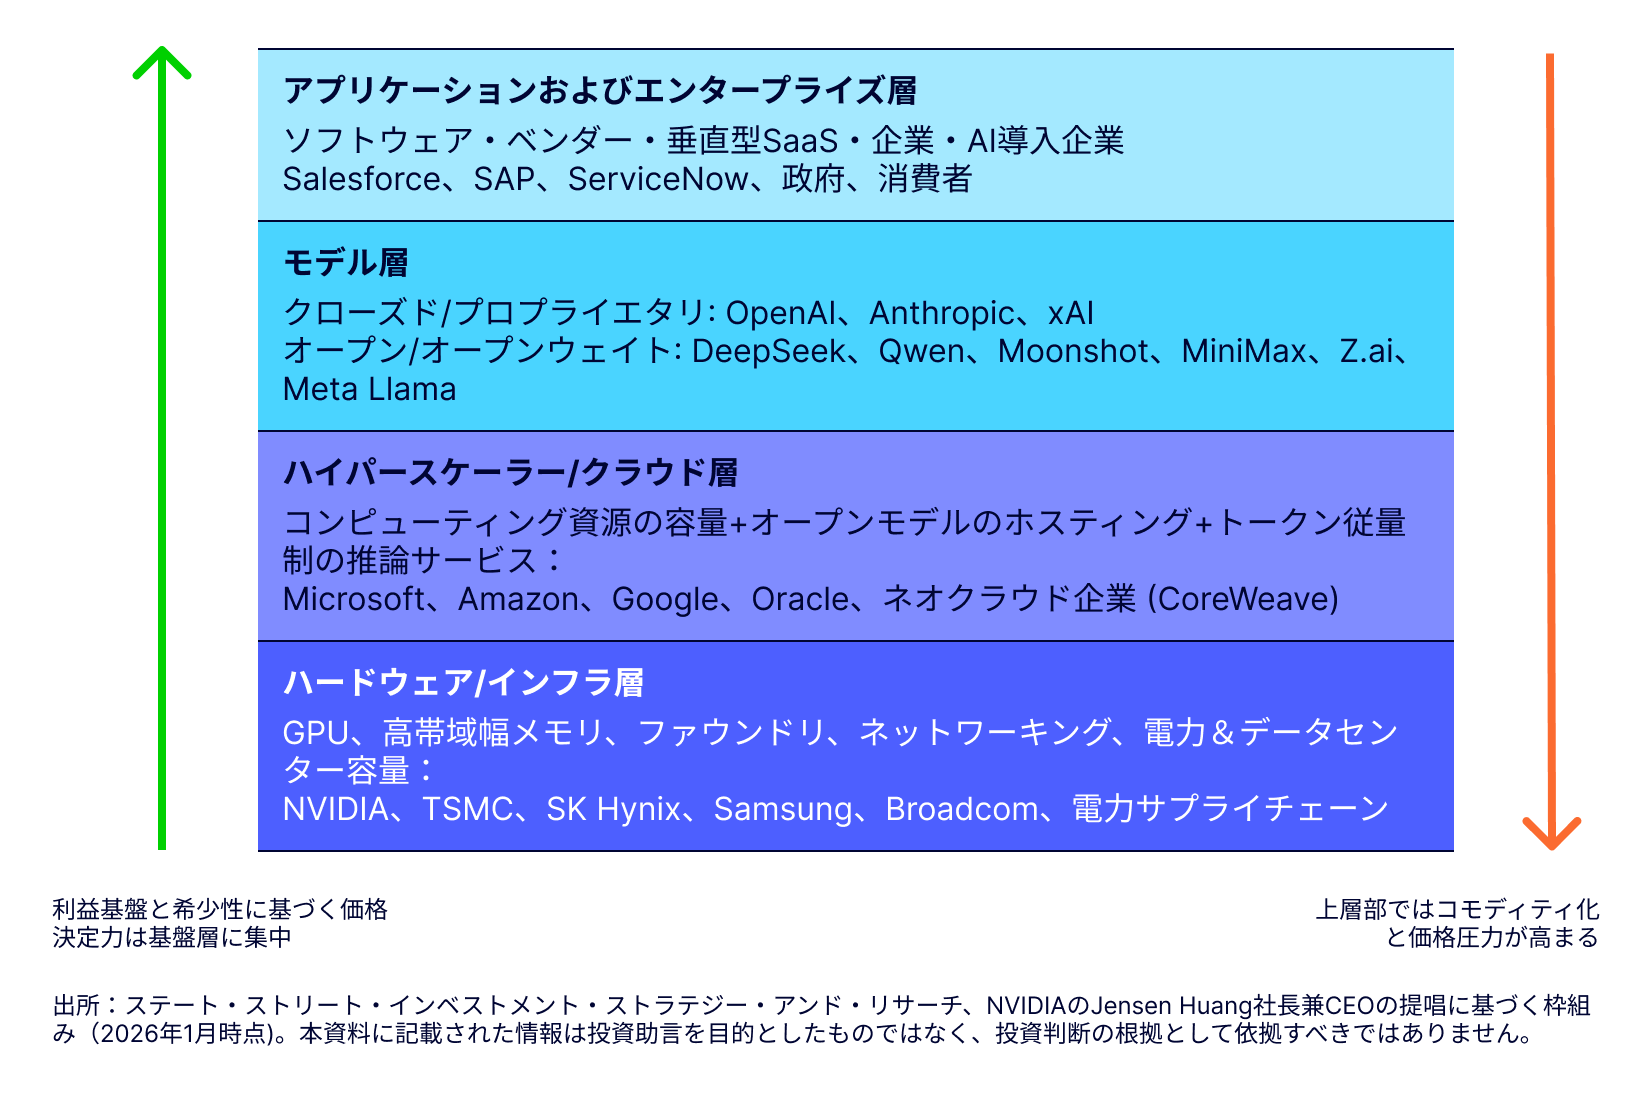
最下層部にあるハードウェア/インフラ層は、希少性に基づく価格設定と健全な利益率を確保できる層です。アジアがこれを支え、最先端のAI用半導体の大部分を供給しています。このため、西側諸国のインフラ構築はアジアのハードウェアに依存しており、NVIDIA、TSMC、SK Hynix、Samsung、Broadcomなど、主要企業の地位を揺るがすのは困難です。
ハイパースケーラーは資本を処理容量に投じ、オープンモデルを自社のクラウド基盤上で稼働・提供することもでき、利用量に応じた課金を行うことも可能です。モデル層は競争が最も激しい分野であり、クローズドモデル(OpenAI、Anthropic、xAI)とオープンウェイト・モデル(DeepSeek、Qwen、Moonshot、Z.ai、およびMeta、NVIDIA)に分かれています。両者の違いは、購入者の入手方法と対価の支払い方法にあります。クローズドモデルは有料の従量課金型APIを通じてレンタルされるため、プロバイダーはアクセスと価格設定をコントロールするのに対し、オープンウェイト・モデルはパラメータを公開しており、ダウンロード、微調整、自己ホスティングが可能であり、大規模利用の場合は格段に安価です。
最上層部には、生産性の恩恵を享受するアプリケーションおよびエンタープライズ層があります。手短に言えば、利益は最下層部に集中し、余剰分は導入側へと流れていきます。
なぜオープンモデルは重要なのか?
オープンモデルによってAIの経済性に対する市場の認識が大きく変わり、導入も進んでいます。Andreessen Horowitz(a16z)や米中レビュー委員会の試算によると、オープンソース技術を基盤に開発を行う米国のスタートアップの約80%が、OpenAIやAnthropicではなく、Qwenなどの中国製モデルを利用しているとされています。Airbnbは実際の運用でQwenを利用している企業の一つです4。同様に、特定の能力にかかるコストも急速に低下しています。Epoch AIの追跡調査によると、推論コストは年間で最大数百分の1まで低下しており、GPT-3.5と同等のモデルの運用コストは2022年終盤と比べて二桁、すなわち100分の1規模まで低下しています(図表4)。当レポートでは、タスクを完了させるための総コストを「知能の価格」と呼んでいます5。
「知能の価格」とは何か?
AIシステムを用いて特定の作業単位を完了するための総コストを指し、百万トークンあたりの表面上の価格ではありません。モデルのアーキテクチャと実際の運用環境によって決まる、タスク実行時に消費するコンピューティング資源の量に、アクセラレータ、メモリ、電力によって決まるコンピューティング資源の価格を乗じた値です。オープンな競争によって前者が圧縮される一方、希少性が後者を下支えするため、「知能の価格」は急速に低下しますが、下限があります。
図表4:「知能」の価格再形成
能力とコスト(2026年中旬)
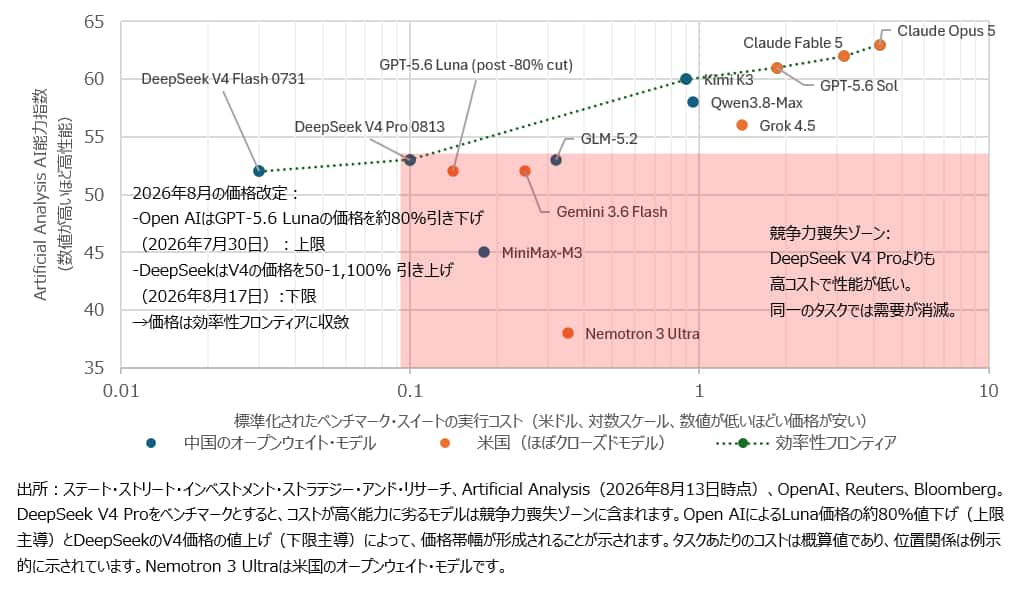
その論理は明快です。或るモデルが他の開発企業のモデルとの競争に打ち勝つには、最も安価で信頼できる選択肢を下回る価格を提示するか、あるいはそれを明らかに上回る能力を発揮しなければなりません。明らかにオープンモデル優位のシナリオに転じるには、以下の2点に注意が必要です:
- AIの能力あたりのコストという点では、最も有力なオープンウェイト・モデルの場合、価格が米国の主要システムを一貫して下回っているわけではありません。コスト面で優位に立つ場合でも、大抵は限定的なタスクにとどまっています。プランニングやツール間の連携を必要とする複雑かつ未解決の問題の処理では、米国のトップモデルが依然として優れた能力を発揮しています。
- またAPI公表価格に目を向けると、クローズドモデルのプロバイダーの優位性が過小評価されることになります。クローズドモデルのブランド力、安全対策ツール、システムへの統合性には、オーブンウェイト・モデルが公開しているウェイトファイル(AIが学習によって獲得した膨大なパラメータを記録したファイル)だけでは埋められないプレミアム価値があります。したがって、効率性は確かに存在しますが、条件付きです。最先端のクローズドモデルとオープンウェイト・モデルが共存するというハイブリッドな結果になる可能性が高いのは、このためです。
コンピューティング資源の不足と「知能の価格」の改定
「知能の価格」の下落には下限があります。制約となる限界は、モデルの能力からコンピューティング資源の利用可能性へと移行しています。GPUのレンタル価格は高止まりしています。DeepSeekはコンピューティング容量の制限を理由にAPI価格を引き上げ6、ギガワット規模の容量を構築中です。AIアクセラレータ専用のメモリである高帯域幅メモリ(HBM)が少数のサプライヤーに集中する中で、ボトルネックとなっています。ハイパースケーラーの持つ予算が5,000億ドルに迫るにつれて、データセンターの電力消費量は2030年までに2倍以上になる見通しです7。
こうした動きは、それ自体がさらなる需要拡大を促す好循環を生みます。Jevonsの論理によると、推論コストの低下によって需要がタスクあたりのコスト削減ペースを上回るペースで拡大し、トークン、演算能力、電力の使用量の増加が進みます。一方、これと反対の状況も成り立ちます。なぜなら、Jevonsの説明は需要についてであり、単位あたりの経済性については説明していません。すなわち、回復が遅れる場合や、需要をけん引する要因が主にエンドユーザーによる導入ではなくエコシステムの資金調達にある場合には、需要の弾力性は膨張したのと同じペースで収縮する可能性があります。
モデル層間の競争激化、AI利用の拡大、コンピューティング資源の継続的な不足が相まって、価格決定力がコンピューティング層へと永続的にシフトしていることが示唆されており、これによってインフラ・プロバイダーと一部のハイパースケーラーが恩恵を受ける一方で、スタンドアローンのモデルの収益性は圧迫される可能性があります。
以下の2つの注意点は、この結果を変える可能性があります:
- コンピューティング資源の不足は、構造的なものであると同時に循環的なものです。なぜなら、積極的な容量増強は、特に借入金を利用するネオクラウドにとって、供給過剰、稼働率の低下、GPUの残存価値低下リスクを招く可能性があります。
- 真の効率化が進めば、コンピューティング資源の不足は予想以上に早く緩和される可能性があります。
上限と下限:「知能の価格」は足元ではレンジ内で推移
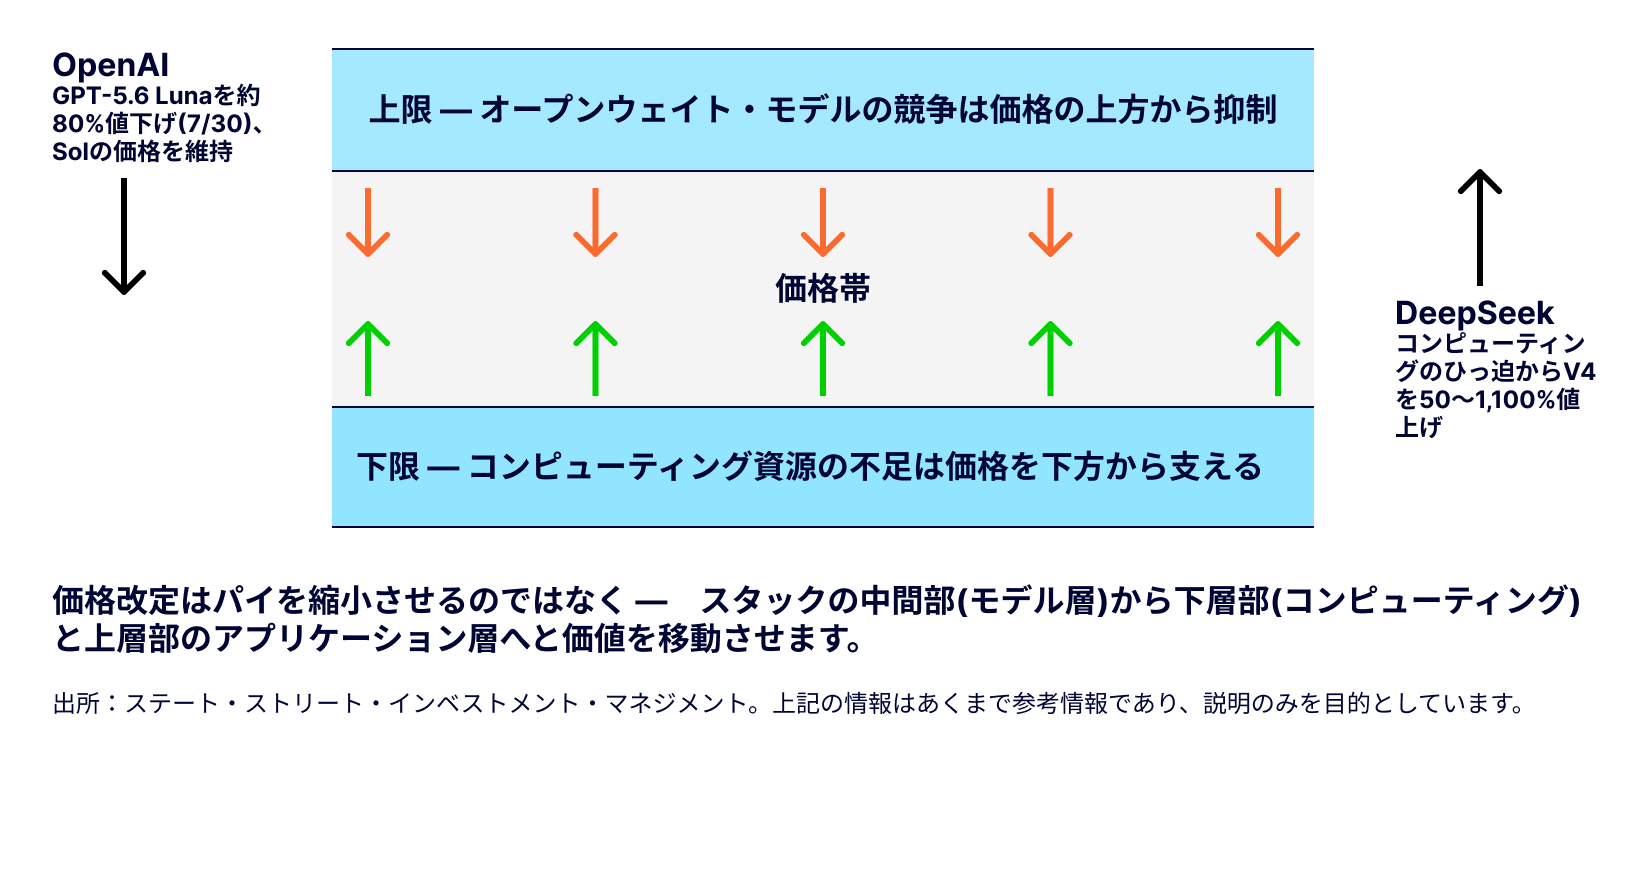
「知能の価格」は下限が形成されたことで、上限と下限に挟まれたレンジ内で推移しています。
1つ目の動き(OpenAIによるLuna価格の値下げ)によって価格の上限が形成されました。Kimi K3の学習済みモデルのウェイト(モデルパラメータ)が無料でダウンロード可能になってから数日後の7月30日、OpenAIはGPT-5.6 Lunaの価格を約80%引き下げる一方で、フラッグシップのSolの価格は据え置きました8。高性能のモデルが無料で導入可能になれば、誰も同一の能力に対して割高な価格を設定できず、最先端以下のモデルの価格はすべて、オープンウェイトのラインへ引き下げられることになります。
2つ目の動き(DeepSeekによるV4価格引き上げ)によって、価格の下限が確認されました。
2週間後、価格戦争に乗り出していたDeepSeekは、コンピューティング資源のひっ迫を同様の理由に、V4の価格を50~1,100%引き上げました9。安価な「知能」は依然として高価で品薄のハードウェアに依存しているため、価格が限りなく下落することはありません。
図表5:上限と下限 ― 「知能の価格」帯
なぜトークン価格には上限と下限があるのか
オープンウェイト・モデルの競争は特定の能力の価格を上から抑える一方で、コンピューティング資源の不足は価格を下から支えます。この上限によって、モデル層は公益事業のような経済モデルへと押しやられ、ラボの利益率は圧迫されます(「AIスタック全体にわたるリスクと機会」の項を参照)。価格の下限によって生じる経済的利益は、コンピューティング資源、メモリ、電力を保有する企業に帰属します。
オープンモデルvsクローズドモデル:想定される3つの未来
当社が検討する3つのシナリオにおいて、決定的な変数は、モデルへのアクセスおよび支払方法です。以下の3つのシナリオすべてにおいて、コンピューティング層は同様の恩恵を享受します。
- オープンモデルが勝利するシナリオ。オープンモデルは最先端モデル並みの使いやすさに達し、推論はプライベートクラウドやエッジデバイスへと分散していきます。これによって、企業向けハードウェア、セキュリティ、オーケストレーション・ソフトウェアが恩恵を受けることになり、MicrosoftとNVIDIAは有利なポジションを維持します。主なリスクとしては、大規模な導入・運用における実装、ガバナンス、信頼性が挙げられます。
- ハイブリッド(基本シナリオ)。最先端のクローズドモデルと強力なオープンウェイト・モデルが共存します。なぜなら、企業は最も困難な推論処理にはプレミアムのシステムを、大量の処理には安価なオープン・システムを利用するからです。これは、大多数の企業がすでに両者を併用しているという調査結果と合致しています10。経済的価値は、クラウドと自社所有のハードウェアにわたって分散しており、ルーティング、セキュリティ、オーケストレーションへの需要を押し上げています。恩恵を受けるのは、ハイパースケーラーやインフラストラクチャ・ソフトウェア企業(Datadog、Palantir、CrowdStrike、ServiceNow)、NVIDIAなどです。
一方、プレミアム層にとって、共存関係には落とし穴があります。能力とコストはモデルによって異なるため、企業にとっての中心的な業務はワークロードの割り当てとなります。すなわち、高コストの最先端のAIモデルは、コストを正当化できる重大な判断を伴う意思決定レベルの業務に割り当てられる一方で、大量の日常業務はすでに「十分に実用的な」安価なモデルに委ねられます。企業の日常的な利用の大部分が後者に該当する場合は、プレミアムAIが提供できる経済的価値は、その能力面の優位性が示すよりも狭い範囲にとどまる可能性があります。したがって、最先端のクローズドモデルが最終的にどれだけの価値を取り込めるかは、最先端モデルの純粋な性能というよりも、コストを正当化できるだけの価値を生み出せるかどうか、そして企業がそれをどのように導入するかに左右されます。注意すべき点は、オープンモデルだからといって必ずしも安価とは限らず、クローズドモデルだからといって必ずしも高価とも限りません。ただし、最先端のクローズドモデルへのアクセスは、一般的にオープンウェイト・モデルよりも高い価格が設定されています。通常は、このような微妙な共存関係が実現しています11。
- クローズドモデルが勝利するシナリオ。最先端モデルとの差が再び拡大します。これは、コンピューティング資源の制約によって中国企業の規模拡大が抑えられる場合に起こり得ます。その結果、買い手は少数のラボに支払い続け、クローズドモデルの競争優位は統合とネットワーク効果によってさらに強まります。このシナリオは信ぴょう性があるものの、ハイブリッド・シナリオよりも可能性は低いとみられます。なぜなら、性能格差は拡大せず縮小していることがこの1年で見られた証拠であり、企業各社はすでにオープンモデルとクローズドモデルを併用する体制を構築しつつあるからです。
3つの将来シナリオすべてに共通する唯一の要素
半導体、ネットワーク、電力など、コンピューティングの屋台骨を構築する企業は、どのパラダイムが主流になろうとも、有利な立場を維持できます。より持続可能なアプローチは、結果にかかわらず勝者となる層に投資することです。
RAIスタック全体にわたるリスクと機会
これらのシナリオには共通する唯一の要素があります。それはコンピューティング基盤です。これは、AIスタック全体にわたるリスクと機会を各層ごとに分析する上での自然な出発点となります。
ハードウェアとインフラ
ハードウェア・インフラ企業は、総需要の増加と資本集約度およびノウハウに守られたポジションに支えられ、構造的に最も明確な勝者となるとみられます。モデルの主導権は数週間で逆転する可能性があるのに対して、先端ロジック、HBM、リソグラフィーにおける主導権は長年にわたって構築されます。この層はオープンモデル価格の「下限」を形成し、その価格決定力はAIスタックの中で最も持続性が高い一方で、景気循環の影響を依然として受けます。中国における内製半導体(Huawei Ascend, Cambricon)への移行は、西側のサプライチェーンを複雑化させる一方で、中国の上場半導体メーカーには支援材料となります。
ハイパースケーラー
オープンモデルはハイパースケーラーの収益性を後押しします。プロバイダーはコンピューティング容量を販売するだけでなく、オープンモデルをホスティングしてその利用から収益化を図り、より高付加価値の収益源を生み出しています。目先のリスクは逆方向の動きです。すなわち、現在のコンピューティング需要の大半は、自社モデルを訓練・運用する少数の最先端ラボに支えられているため、オープンな競争によって収益化が圧迫されると、その支出とハイパースケーラーの受注残が冷え込む可能性があります。決定的な変数は需要構成です。幅広い推論や企業向けの作業は、まとまった単位で不規則に発生する最先端ラボとの契約よりも底堅いため、主要な設備投資額と同じくらい注意深く需要構成を見ていく必要があります。
AIラボ
AIラボはオープンモデルの上限の真下に位置しているため、最も困難な課題に直面しています。現在、最先端の分野で自由に導入できるモデルが登場したため、他で安価に利用できる能力に対して、どのAIラボもプレミアム価格を課すことはできません。価格決定力は最先端領域においてのみ、そしてその優位性が続く期間においてのみ維持されます。AIラボを支えてきた好循環は、今やあらゆる局面で圧力にさらされています。(図表6)
図表6:オープンウェイトによる競争が従来のAIの好循環をいかに混乱させるか
| 従来のAIラボの好循環 | オープンウェイトによる競争がもたらす影響 |
|---|---|
| 最先端の分野で他社をリード | 今や主導権は数年ではなく、数週間で逆転する |
| プレミアム価格で高い利益率を確保 | オープンウェイト・モデル間の競争が価格を限界コストへと押し下げる |
| コンピューティング資源と人材への投資を拡大 | 「十分に実用的な」モデルの普及に伴い資本力による優位性は薄れる |
| さらに高いプレミアム価格を設定 | 好循環が弱まり、収益化とバリュエーションが揺らぐ |
出所:ステート・ストリート・インベストメント・ストラテジー・アンド・リサーチ
Open AIとAnthropic(両社とも上場申請済み)のバリュエーションは高利益率に依存していますが、今やその高利益率はオープンな競争に試されています12。最先端ラボは能力、安全性、ブランド力、統合性の面で真の優位性を維持しているため、不利となる結果は避けられる可能性もあります。問題は、足元のバリュエーションがそうした優位性や想定される競争優位の持続性を適切に反映しているかどうかです。
企業向けAIの導入
裏を返すと、導入企業には好機があります。推論コストと参入障壁の低下に伴い、より多くの経済的価値がAIを実用化する企業やソフトウェア企業へ移っており、タスクの計画・構造化にプレミアム・モデルを既に使用しているチームもあり、その後の実行段階でより安価なオープンモデルに引き継ぐというやり方を取っています。
米中のAI競争における戦略的な意味合い
中国の進展は、米国のAIスタックを普及させてそれを世界標準にするのか、それとも輸出規制を通じて中国の進展を遅らせるかという米国のジレンマを浮き彫りにしています。この2つの目標は相反します。なぜなら、規制を強化すると、第三国の顧客はHuaweiなど中国の安価な企業を選択する一方で、規制を緩めると、中国のコンピューティング資源へのアクセスに対する支配力が弱まるからです。直近の動向は、コンピューティング資源がひっ迫する状況下でさらに複雑化しており、コンピューティング資源を抑制すれば計算能力を確実に制限できるという想定に疑問符を突きつけています。
商業的な利害関係は明白です。一方が数セントで提供するものを他方が数ドルで提供すれば、勝敗がついていない市場では競争がシフトし、知的財産をめぐる紛争や制裁リスクへと摩擦は既に広がっています。また、規制を強化する度に、中国の内製半導体の開発を加速させ、エコシステムは対抗する規格へと分断される可能性があります。政策・規制は今や、AIから生まれる経済的価値を誰が取り込むかを左右する主要因であり、オープンモデルとクローズドモデルのどちらが優位になるかを決める重要な変動要因でもあります。政策・規制がもたらす結果は予測が困難ですが、グローバルの環境下で中国のAIエコシステムはますます重要な役割を担うとみられます。このため、AIがもたらす機会に関しては幅広い視点を持つ必要があります。
ます。米国では30を超える企業で構成される連合体が「Open Secure AI Alliance」を立ち上げており13、少数のゲートキーパーが「知能」へのアクセスをコントロールするリスクをオープンモデルによって低減することを目指しています。
破壊的革新から持続的な競争へ
これはDeepSeekショックの再来なのでしょうか?当社の答えは「条件付きのノー」です。これは「DeepSeekショックの再来」を超える出来事かもしれませんが、中国と米国の最先端モデルが対等な立場にあることを示す証拠はまだありません。単一企業によるコスト主導のサプライズは、能力と規模を兼ね備え、実際の運用規模で導入可能な複数企業による競争へと発展しました。その結果、今や中国は、コンピューティング資源の制約にもかかわらず、最先端に近いモデルを継続的に生み出せる体制を構築しています。
これまで見られてきた証拠は、持続性のあるシステムが形成され、価値は破壊されるのではなくAIスタック内で再配分され、コンピューティング資源が決定的な制約要因であり続け、勝ち組はどのシナリオでも優位性を保ち続けることを示しています。一方、3つの疑問が残されています。すなわち、1)中国が性能面で最後に残るギャップを埋められるかどうか、2)より安価な「知能」が、実証された経済的成果につながるか、3)米中間のポリシーの対立はどう解決されるか、という疑問です。
投資家が今後12~24カ月間に注目すべき事柄
中国の最近のAIの進展が産業の経済性と競争上の地位の長期的な変化を示しているのか、それとも一時的な格差縮小を示すものなのかを判断する上で、下記の指標が役立ちます。
- 実世界のパフォーマンスにおけるオープンモデルとクローズドモデルの格差
- AIのコスト低下に伴うトークン消費量の伸び
- コンピューティング需要:供給不足か供給過剰か
- トレーニング、推論、企業向けAIワークロードへの需要
- モデル層における収益化と価格決定力
- 「知能」の価格帯の形成と進化
- 企業の生産性向上と収益化を示す確固たる証拠
- 輸出規制、制裁、エコシステムの分断
投資姿勢
当社はどのモデル層が勝者になるかについての確証はありません。より確信度の高い見解は、すべてのシナリオで恩恵を受けるコンピューティング資源とインフラ基盤に加えて、安価で潤沢な「知能」を収益化する上で最も有利な立場にいるハイパースケーラーと導入企業が勝者になるというものです。モデル層は最大の上振れ余地を持つ一方で、リスクも最も大きいため、それに応じて投資配分を調整する必要があります。
寄稿者